Now Reading: Come funzionano i modelli AI: training, inferenza e contesto
-
01
Come funzionano i modelli AI: training, inferenza e contesto
Come funzionano i modelli AI: training, inferenza e contesto

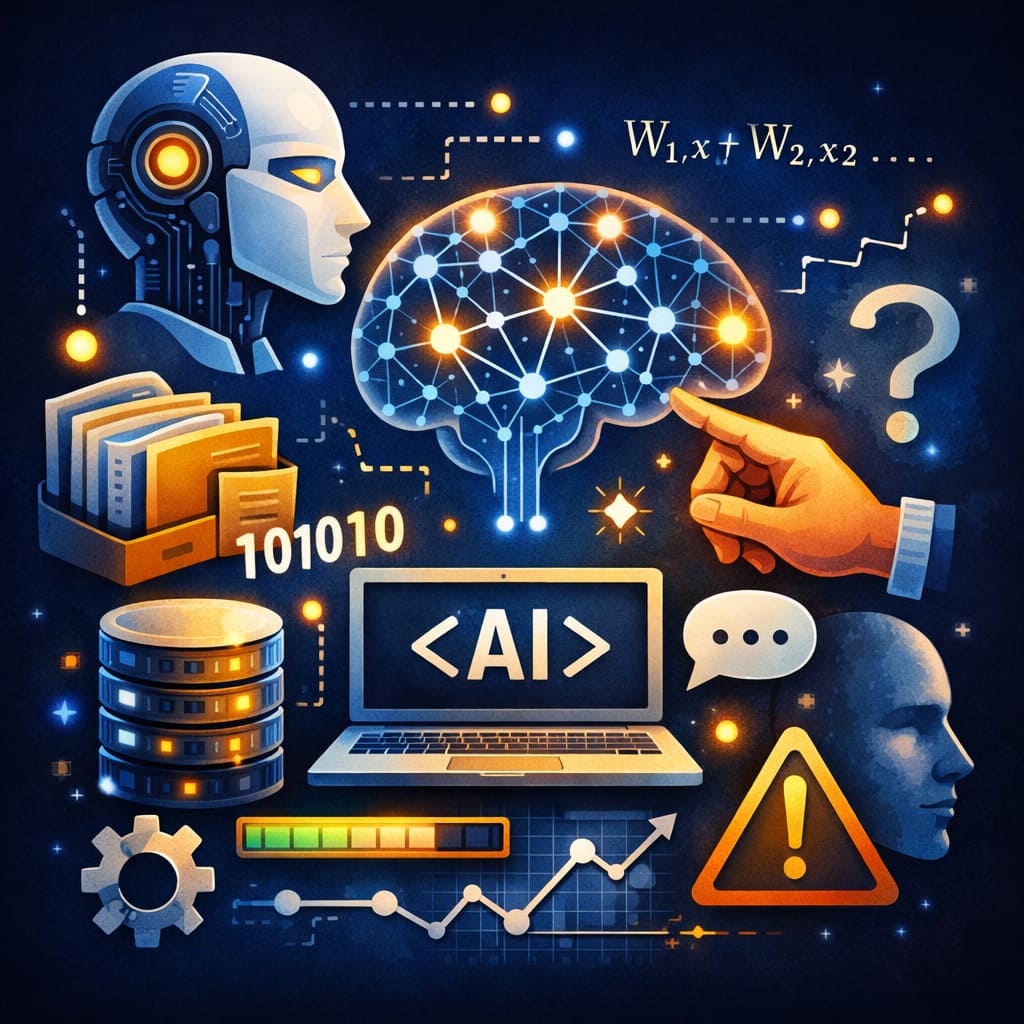
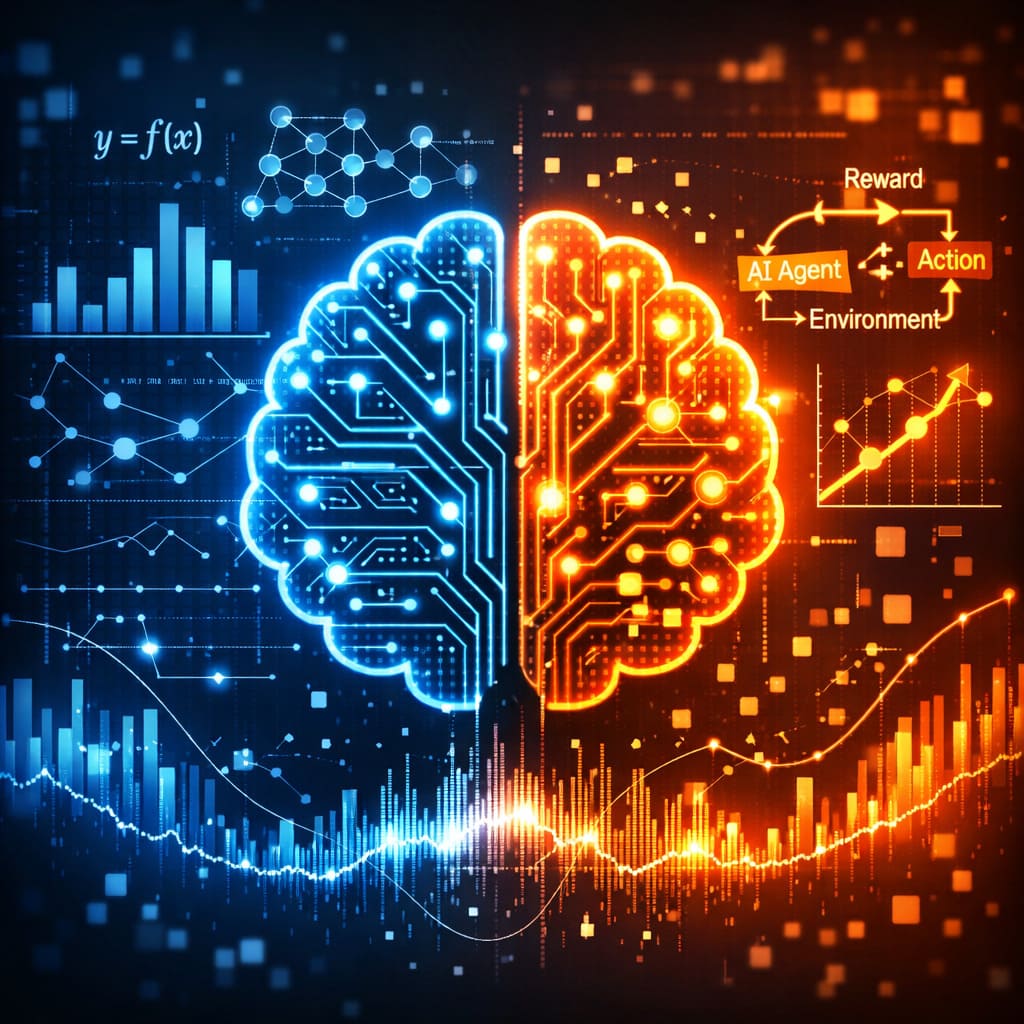
Un modello AI non “sa” le cose come una persona: apprende parametri dai dati e usa quei parametri per produrre output durante l’inferenza.
Dire che un modello di intelligenza artificiale “impara dai dati” è corretto, ma non basta. Per capire davvero come funziona un modello AI bisogna separare almeno quattro fasi: preparazione dei dati, addestramento, inferenza e integrazione del modello dentro un sistema più grande.
Il modello, da solo, non è l’intero prodotto. È una funzione matematica con molti parametri che trasforma input in output. Chatbot, generatori di immagini, sistemi di raccomandazione e strumenti di analisi aggiungono poi memoria, interfacce, database, ricerca e strumenti esterni.
Un modello AI è una funzione con parametri appresi
Nel machine learning non programmiamo esplicitamente ogni regola. Definiamo invece un’architettura e un obiettivo, poi lasciamo che il sistema modifichi i propri parametri per ridurre l’errore sui dati di addestramento.
In un modello semplice i parametri possono essere pochi. Nei modelli moderni possono essere miliardi. Il punto, però, non cambia: durante il training il sistema cerca configurazioni dei parametri che producano risultati migliori rispetto all’obiettivo scelto.
Per questo è utile distinguere il modello dal dataset. I dati forniscono gli esempi; il modello costruisce una rappresentazione statistica delle regolarità che trova in quegli esempi.
Training: come avviene l’apprendimento
Durante il training il modello riceve molti esempi, produce previsioni, misura quanto sono lontane dal risultato desiderato e modifica gradualmente i parametri. Questo processo viene ripetuto moltissime volte.
Nei modelli neurali la correzione avviene attraverso tecniche come backpropagation e gradient descent. Non significa che la rete comprenda l’errore nel senso umano del termine: calcola come ogni parametro contribuisce alla funzione di perdita e lo aggiorna nella direzione che dovrebbe ridurla.
La guida di Google al machine learning sottolinea anche un punto spesso ignorato: in produzione il modello è soltanto una parte del sistema. Raccolta dati, validazione, monitoraggio, infrastruttura e serving possono essere altrettanto importanti del codice del modello.
Inferenza: quando il modello viene usato
Una volta addestrato, il modello entra nella fase di inferenza. Qui i parametri non vengono normalmente riscritti a ogni richiesta: vengono usati per calcolare una risposta a partire da un nuovo input.
Per un modello linguistico l’input viene trasformato in token e rappresentazioni numeriche. Il modello stima poi quali token siano plausibili come continuazione, uno dopo l’altro. È la base dei modelli linguistici di grandi dimensioni.
Questa distinzione spiega perché una conversazione con un chatbot non equivale automaticamente a “riaddestrare” il modello. L’interazione può entrare nel contesto della sessione o in sistemi di memoria separati senza modificare i pesi di base.
Il contesto non è la stessa cosa della memoria del modello
Quando fornisci un documento, una conversazione precedente o istruzioni aggiuntive, il sistema può inserirle nella finestra di contesto. Il modello usa quelle informazioni per produrre la risposta corrente, ma ciò non significa che siano diventate nuove conoscenze permanenti nei suoi parametri.
È una distinzione fondamentale. I parametri derivano dal training; il contesto è informazione disponibile durante l’inferenza. Confondere i due livelli porta a descrivere l’AI come se riscrivesse continuamente se stessa a ogni messaggio.
Retrieval: quando il modello cerca informazioni esterne
Un modello può anche ricevere dati recuperati da una fonte esterna. Nei sistemi RAG, per esempio, una ricerca individua documenti rilevanti e li passa al modello insieme alla domanda. Il modello non deve avere tutto nei propri parametri: può ragionare su informazioni recuperate al momento.
Questo approccio è utile per documentazione aziendale, knowledge base e contenuti aggiornati. Riduce il bisogno di riaddestrare il modello ogni volta che cambia un’informazione, ma introduce nuovi problemi: qualità della ricerca, permessi, documenti obsoleti e possibilità che una fonte contenga istruzioni malevole.
Tool e agenti: il modello può anche agire
I sistemi più recenti collegano il modello a strumenti: browser, API, database, terminali, calendari o software aziendali. A quel punto il modello non produce soltanto testo. Può scegliere quale funzione chiamare, leggere il risultato e proseguire.
È il passaggio che porta agli agenti AI. L’intelligenza percepita dipende quindi sempre di più dall’intero sistema: modello, contesto, retrieval, strumenti, memoria e regole di orchestrazione.
Perché i modelli possono sbagliare pur essendo molto capaci
Un modello ottimizza un obiettivo statistico. Non possiede automaticamente un meccanismo interno che garantisca la verità di ogni affermazione. Può generalizzare bene e allo stesso tempo produrre risposte inesatte quando il pattern più probabile non coincide con il fatto corretto.
Dataset, obiettivo di training, architettura e modalità di inferenza determinano quindi limiti e punti di forza. Per questo parlare di “AI” come di un’unica capacità indistinta è poco utile: modelli diversi possono essere costruiti per compiti, costi e vincoli molto differenti.
La parte più importante è distinguere modello e sistema
Capire questa separazione rende più leggibili quasi tutte le notizie sull’AI. Un miglioramento può derivare da un nuovo modello, da più contesto, da una ricerca migliore, da strumenti aggiuntivi o da un sistema di orchestrazione più efficace.
Il modello resta il motore matematico centrale, ma il prodotto che usiamo è ormai una macchina molto più grande. Valutarne capacità e rischi significa osservare entrambi i livelli.