Now Reading: Come impara una macchina: il machine learning senza magia
-
01
Come impara una macchina: il machine learning senza magia

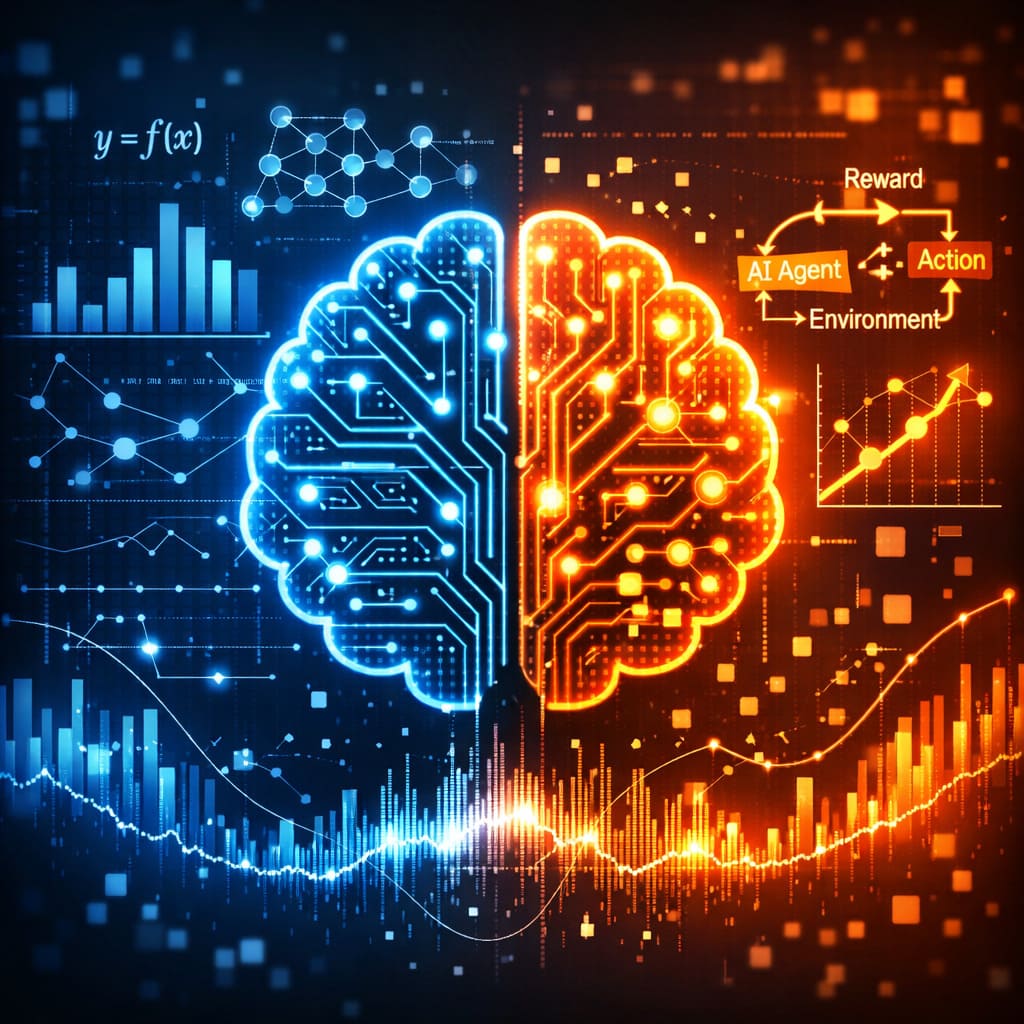
Il machine learning non consiste nel programmare ogni regola: consiste nel far apprendere a un modello regolarità dai dati e verificare se riesce a generalizzare su casi che non ha già visto.
Il machine learning cambia il modo in cui costruiamo un software: invece di descrivere a mano ogni regola, forniamo dati, un obiettivo e un processo di ottimizzazione che permette al modello di trovare regolarità utili. La parte difficile non è far sì che il sistema ricordi gli esempi. È verificare che sappia comportarsi bene su dati nuovi.
Questo è il motivo per cui il machine learning occupa una posizione centrale nell’intelligenza artificiale moderna. Molti sistemi che chiamiamo AI — classificatori, motori di raccomandazione, modelli generativi — dipendono da tecniche di apprendimento automatico, anche se usano architetture e obiettivi molto diversi.
Cos’è il machine learning
Il machine learning è un insieme di metodi attraverso cui un modello modifica i propri parametri sulla base dei dati. L’obiettivo è minimizzare un errore o massimizzare una ricompensa, in modo che il sistema impari una funzione utile: riconoscere una categoria, stimare un valore, prevedere un evento, produrre una sequenza o scegliere un’azione.
La definizione sembra astratta, ma il punto pratico è semplice. In un programma tradizionale lo sviluppatore scrive la regola. Nel machine learning lo sviluppatore definisce dati, architettura, obiettivo e procedura di training; la regola operativa emerge dall’ottimizzazione dei parametri.
Dal dato al modello: come funziona il processo
Un progetto di machine learning non comincia dal modello ma dai dati e dal problema. Bisogna decidere quali esempi rappresentano il fenomeno, quali informazioni utilizzare e quale risultato misurare. I dataset non sono quindi un dettaglio logistico: contribuiscono a definire ciò che il sistema potrà imparare.
Durante il training, il modello riceve esempi e confronta le proprie previsioni con l’obiettivo. Una funzione di perdita misura l’errore; un algoritmo di ottimizzazione modifica i parametri per ridurlo. Il processo si ripete molte volte.
Alla fine non interessa soltanto quanto il modello sia bravo sui dati di training. Serve una fase di validazione e test per capire se la prestazione regge su esempi non usati per l’apprendimento. È la differenza tra ricordare e generalizzare.
Supervised learning: imparare da esempi etichettati
Nel supervised learning ogni esempio contiene input e risposta attesa. Possiamo mostrare migliaia di email etichettate come spam o non spam, fotografie con la classe corretta, transazioni con un esito noto.
Il modello cerca una relazione tra input e output e viene corretto quando sbaglia. È adatto a problemi di classificazione e regressione, ma dipende dalla qualità delle etichette e da quanto il dataset rappresenti il mondo reale.
Unsupervised learning: trovare struttura senza una risposta già scritta
Nell’unsupervised learning non abbiamo una risposta corretta associata a ogni esempio. Il sistema cerca regolarità, gruppi o rappresentazioni nei dati. Tecniche di clustering possono, per esempio, separare profili con comportamenti simili senza che qualcuno abbia definito in anticipo le categorie.
È utile quando vogliamo esplorare una struttura che non conosciamo ancora, ma la scoperta di un pattern non implica automaticamente che quel pattern abbia un significato causale o utile.
Self-supervised learning: il ponte verso i modelli generativi
Il self-supervised learning crea il segnale di apprendimento direttamente dai dati. Invece di pagare qualcuno per etichettare miliardi di frasi, possiamo nascondere o prevedere parti del contenuto e usare il resto come contesto.
Gli LLM sfruttano proprio questa logica su scala enorme: imparano a prevedere token usando il testo stesso come sorgente del problema. È uno dei motivi per cui è stato possibile addestrare modelli su quantità di dati molto più grandi dei tradizionali dataset etichettati manualmente.
Reinforcement learning: imparare dalle conseguenze
Nel reinforcement learning un agente sceglie azioni in un ambiente e riceve ricompense o penalità. Non apprende una singola risposta corretta, ma una strategia che massimizzi il risultato nel tempo.
Questo approccio compare nella robotica, nei giochi, nell’ottimizzazione e in alcune fasi di post-training dei sistemi generativi. Non va però confuso con l’intera categoria degli agenti AI: un agente può usare tecniche molto diverse e non necessariamente apprendere online dalle proprie azioni.
Overfitting: quando il modello impara troppo bene gli esempi sbagliati
Un modello può ottenere risultati eccellenti sui dati di training e fallire appena incontra casi nuovi. È l’overfitting: il sistema si adatta troppo alle particolarità del campione invece di catturare regolarità più generali.
Per ridurlo servono dati adeguati, separazione corretta tra training e test, regolarizzazione, controllo della complessità e valutazioni realistiche. Questo punto è importante perché mostra che “più addestramento” non equivale sempre a “più intelligenza”.
Training e inferenza non sono la stessa cosa
Durante il training il modello cambia i propri parametri. Durante l’inferenza usa invece ciò che ha appreso per elaborare nuovi input. È la distinzione che spiega perché un modello può essere costosissimo da addestrare e poi essere eseguito molte volte senza ripetere l’intero processo.
La nostra guida su come vengono addestrati i modelli AI entra nel dettaglio di questa fase, mentre come funzionano i modelli AI collega training, inferenza e contesto.
Machine learning, deep learning e AI generativa
Questi termini non sono sinonimi. Il machine learning è il contenitore più ampio. Il deep learning è una famiglia di tecniche basata su reti neurali profonde. L’AI generativa indica sistemi progettati per produrre nuovi contenuti, molti dei quali sono costruiti con deep learning.
Le reti neurali sono quindi un’architettura; il machine learning descrive il paradigma di apprendimento; “generativo” descrive il tipo di funzione che ci interessa ottenere. Tenere separati questi livelli evita gran parte della confusione terminologica.
Dove incontriamo il machine learning
Motori di raccomandazione, filtri antispam, rilevamento delle frodi, riconoscimento vocale, ricerca, moderazione automatica e sistemi di previsione usano forme diverse di machine learning. A volte il modello è visibile all’utente; più spesso lavora dentro l’infrastruttura.
La tecnologia non è quindi nuova soltanto perché oggi la chiamiamo AI. È cambiata la scala: più dati, più capacità di calcolo, architetture più grandi e modelli capaci di essere riutilizzati per compiti differenti.
Quando il machine learning non serve
Un errore frequente consiste nell’applicare ML a problemi che hanno già una regola deterministica semplice. Se dobbiamo calcolare un’IVA, verificare un formato o applicare una condizione chiara, un algoritmo tradizionale è spesso più economico, trasparente e prevedibile.
Il machine learning ha senso quando la relazione tra input e risultato è troppo complessa per essere descritta bene con regole esplicite, e quando abbiamo dati e metriche sufficienti per valutare il comportamento del modello.
Bias e distribuzione dei dati
Un modello apprende dal campione che gli forniamo. Se alcune situazioni sono rare, rappresentate male o etichettate in modo incoerente, la prestazione può cambiare molto tra gruppi e contesti. Il bias non nasce soltanto dal codice: può entrare nella scelta dei dati, nell’obiettivo e nella metrica con cui dichiariamo il sistema “accurato”.
Un altro problema è il distribution shift: il mondo reale cambia rispetto ai dati su cui il modello è stato costruito. Comportamenti, mercati, frodi, linguaggi e dispositivi evolvono. Per questo un sistema di machine learning non è “finito” al momento del deployment: va monitorato per capire quando la sua prestazione smette di rappresentare la realtà.
Accuratezza non basta: scegliere la metrica giusta
Due modelli con la stessa accuratezza media possono avere conseguenze molto diverse. In un filtro antispam può essere tollerabile qualche messaggio perso; in un sistema medico o antifrode i costi di falso positivo e falso negativo possono essere asimmetrici.
La metrica è quindi una decisione sul problema, non soltanto una misura tecnica. Precision, recall, errore medio o tasso di successo hanno senso solo se corrispondono a ciò che conta davvero nell’applicazione.
La domanda decisiva è come generalizza
La parte affascinante del machine learning non è che un computer possa adattare dei numeri. È che da molti esempi possa costruire una funzione utile anche su casi non identici a quelli già osservati.
La parte rischiosa è la stessa: se i dati non rappresentano il mondo, se la metrica misura la cosa sbagliata o se l’ambiente cambia, il modello può generalizzare male mantenendo comunque un’apparenza di precisione. Capire il machine learning significa quindi capire insieme capacità, dati e valutazione.