Now Reading: Reti neurali: cosa sono e come imparano davvero
-
01
Reti neurali: cosa sono e come imparano davvero

Le reti neurali non sono cervelli artificiali: sono modelli matematici a strati che imparano regolando pesi per ridurre l’errore su molti esempi.
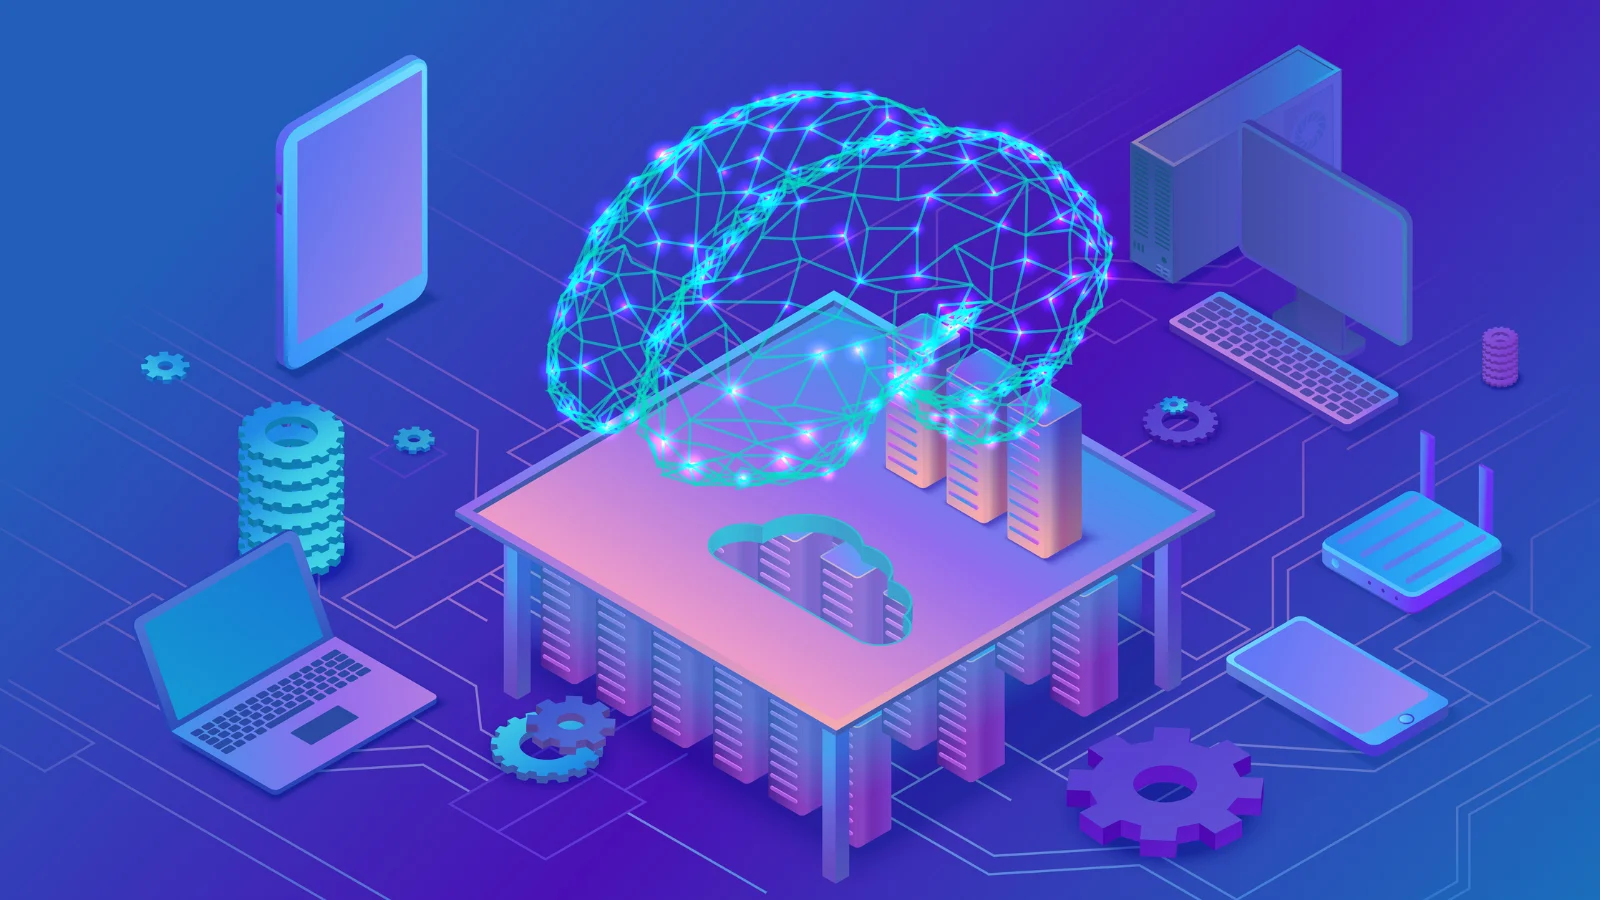
Definire una rete neurale un “cervello artificiale” può aiutare a creare un’immagine intuitiva, ma rischia di spiegare male la tecnologia. Le reti neurali artificiali sono modelli matematici organizzati in strati che trasformano input in output attraverso parametri appresi dai dati.
L’ispirazione storica viene molto lontanamente dai neuroni biologici, ma i sistemi moderni non sono simulazioni realistiche del cervello e non è necessario attribuire loro coscienza o intenzioni per capirne il funzionamento.
Da input a output attraverso strati
Una rete riceve valori in ingresso, li combina con pesi numerici, applica trasformazioni e passa i risultati agli strati successivi. Lo strato finale produce la previsione: una categoria, un numero, una probabilità o una rappresentazione.
Una singola unità è semplice. La potenza nasce dalla combinazione di moltissime unità e livelli.
I pesi sono ciò che la rete impara
All’inizio i pesi non contengono una soluzione utile. Durante il training il modello produce una previsione, la confronta con l’obiettivo e calcola un errore.
Un algoritmo di ottimizzazione modifica poi i pesi per ridurre l’errore. Ripetendo il processo su molti esempi, la rete impara rappresentazioni che permettono di generalizzare a nuovi input.
Backpropagation: distribuire l’errore nella rete
La backpropagation calcola come ogni parametro ha contribuito all’errore usando le derivate. Queste informazioni permettono all’ottimizzatore di aggiornare i pesi nella direzione che dovrebbe migliorare il risultato.
Il concetto è meno misterioso di quanto sembri: la rete sbaglia, misura in che modo i parametri hanno influenzato lo sbaglio e li corregge di poco.
Le funzioni di attivazione rendono la rete non lineare
Se ogni strato applicasse soltanto trasformazioni lineari, una rete profonda collasserebbe matematicamente in una trasformazione molto più semplice. Le funzioni di attivazione introducono non linearità e permettono di rappresentare relazioni complesse.
Google nel proprio corso di machine learning usa proprio questo passaggio per spiegare perché più layer possono apprendere strutture che un semplice modello lineare non riesce a catturare.
Che cosa significa deep learning
Il deep learning utilizza reti neurali con molti strati e grandi quantità di parametri. “Profondo” non significa cosciente o più intelligente in senso umano: indica la profondità dell’architettura.
Questi modelli sono alla base di riconoscimento immagini, sintesi vocale, traduzione, raccomandazione e gran parte dell’AI generativa moderna.
Anche i transformer sono reti neurali
I grandi modelli linguistici non hanno abbandonato le reti neurali. I transformer sono una particolare architettura neurale costruita attorno a meccanismi di attenzione e rappresentazioni vettoriali.
È quindi sbagliato contrapporre “reti neurali” e “LLM”: un LLM moderno è normalmente una grande rete neurale di tipo transformer.
Imparare pattern non significa imparare verità
Una rete ottimizza un obiettivo sui dati disponibili. Se il dataset contiene errori o rappresenta male il mondo, il modello può imparare quelle distorsioni.
Per questo l’articolo sui dataset è il complemento naturale di questo: architettura e dati determinano insieme ciò che la rete può imparare.
Perché le reti neurali sono diventate così importanti
Tre fattori hanno contribuito alla loro diffusione: grandi quantità di dati, hardware capace di eseguire calcoli paralleli e progressi nelle architetture e nelle tecniche di training.
Il risultato non è un cervello artificiale nel senso letterale. È una famiglia di modelli capace di apprendere rappresentazioni complesse e di trasformarle in previsioni, classificazioni e contenuti generati.