Now Reading: Edge computing: cos’è e perché porta il calcolo vicino ai dati
-
01
Edge computing: cos’è e perché porta il calcolo vicino ai dati

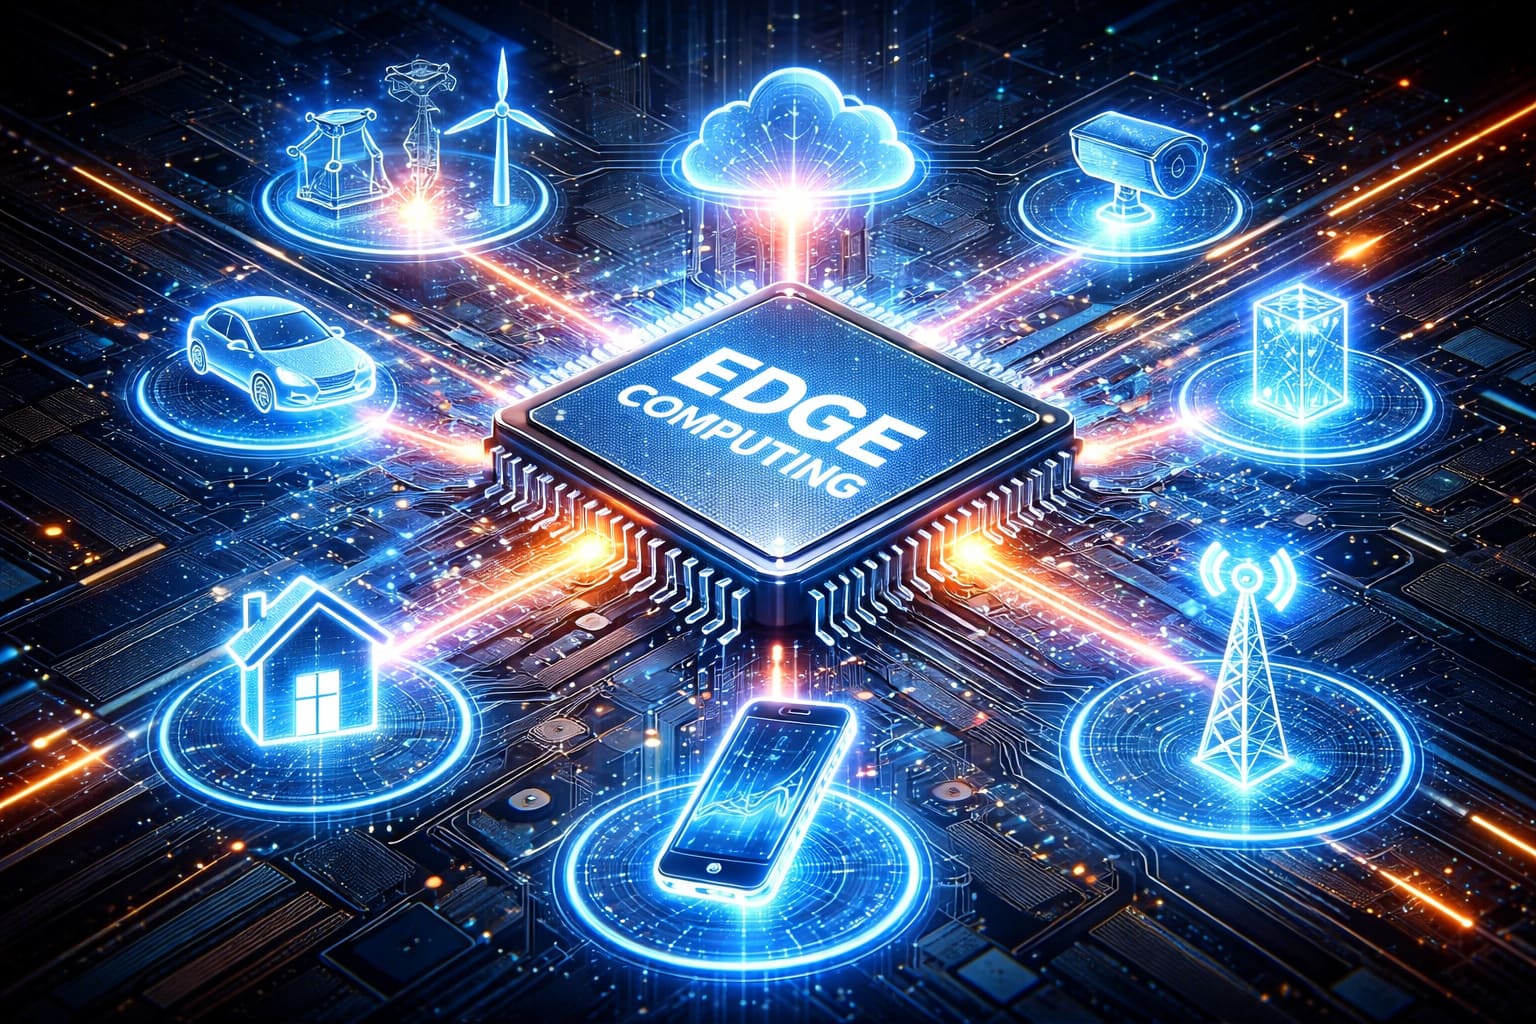
L’edge computing sposta una parte dell’elaborazione vicino alla fonte dei dati. Non sostituisce il cloud: distribuisce il calcolo tra dispositivo, edge e data center.
Il cloud ha abituato aziende e utenti a immaginare il calcolo come qualcosa che avviene lontano, dentro grandi data center. L’edge computing sposta invece una parte dell’elaborazione vicino al luogo in cui i dati vengono prodotti: fabbriche, automobili, negozi, antenne, sensori o dispositivi.
Non è il contrario del cloud. È un modo per distribuire il lavoro tra livelli differenti dell’infrastruttura.
Perché elaborare tutto nel cloud non è sempre efficiente
Inviare ogni dato a un server remoto richiede rete, tempo e banda. Per molte applicazioni pochi millisecondi fanno differenza: controllo industriale, veicoli, realtà aumentata, sistemi di sicurezza e robotica.
Se il sistema deve reagire immediatamente, elaborare una parte dei dati vicino alla fonte riduce la latenza.
Edge non significa necessariamente “sul dispositivo”
Il termine comprende più livelli. L’elaborazione può avvenire direttamente sul sensore, su un gateway locale, in un piccolo data center vicino all’utente o in un’infrastruttura dell’operatore di rete.
La caratteristica comune è la prossimità rispetto alla fonte dei dati, non una singola architettura.
Il cloud rimane importante
Molti sistemi edge continuano a inviare dati aggregati al cloud per analisi più pesanti, storage, coordinamento o training dei modelli. Il cloud offre capacità elastiche e centralizzate che sarebbe costoso replicare in ogni sito.
Il modello realistico è quindi spesso ibrido: decisioni rapide all’edge, elaborazioni più intensive nel data center.
IoT: milioni di sensori producono troppi dati
L’Internet of Things rende l’edge particolarmente utile. Una fabbrica può avere migliaia di sensori che generano continuamente misurazioni. Trasmettere tutto in forma grezza può essere inutile e costoso.
Un gateway può filtrare, comprimere o analizzare localmente i flussi e inviare al cloud soltanto eventi significativi.
AI all’edge
I modelli di machine learning possono essere eseguiti anche vicino ai dispositivi. Telecamere intelligenti possono rilevare oggetti senza inviare ogni fotogramma a un server remoto; sistemi industriali possono individuare anomalie direttamente sulla linea.
Questo riduce traffico e può migliorare privacy, ma richiede hardware capace e modelli sufficientemente efficienti.
Digital twin e edge lavorano bene insieme
Un digital twin può dipendere da dati continui provenienti dal mondo fisico. L’edge permette di pulire ed elaborare quei dati prima di aggiornarne la rappresentazione digitale.
In sistemi complessi, il gemello può quindi essere alimentato da una catena distribuita di elaborazione locale e centrale.
La privacy può migliorare, ma non automaticamente
Elaborare dati localmente può evitare l’invio di informazioni grezze verso un cloud. È utile per immagini, audio o dati industriali sensibili.
Ma un dispositivo edge può essere fisicamente esposto, poco aggiornato o mal configurato. Spostare il calcolo cambia la superficie di rischio: non la elimina.
La sicurezza diventa più distribuita
Un data center centralizza controlli e aggiornamenti. Migliaia di nodi edge richiedono gestione remota, autenticazione, patch e monitoraggio. Il numero di componenti aumenta e con esso la complessità operativa.
È uno dei motivi per cui edge computing e cybersecurity devono essere progettati insieme.
Il valore dell’edge è decidere dove conviene calcolare
La vera idea non è “portare tutto fuori dal cloud”. È scegliere il posto più adatto per ogni lavoro. Alcuni dati devono essere elaborati immediatamente e localmente; altri possono aspettare ed essere aggregati; altri ancora richiedono la potenza di un grande cluster.
L’edge computing rende l’infrastruttura meno centralizzata e più sensibile al contesto fisico. Più il digitale entra in macchine, fabbriche e città, più questa distinzione diventa importante.
Esempio pratico: una telecamera industriale
Una telecamera che controlla una linea produttiva può generare decine di fotogrammi al secondo. Inviare tutto al cloud sarebbe costoso e introdurrebbe latenza. Un dispositivo edge può eseguire localmente il modello di visione, scartare i fotogrammi normali e trasmettere soltanto anomalie o metadati.
Questo esempio mostra il principio fondamentale: portare il calcolo dove serve, non necessariamente dove si trova il data center più grande.
5G ed edge computing sono collegati ma non equivalenti
Le reti mobili a bassa latenza possono rendere più utile l’elaborazione vicina all’utente, ma l’edge esiste anche senza 5G. Una fabbrica può avere server locali collegati via rete privata; un dispositivo può eseguire inferenza completamente offline.
Il 5G è quindi una possibile infrastruttura di accesso, non la definizione dell’edge.
Quando l’edge non serve
Se i dati sono pochi, la latenza non è critica e il cloud offre già costi e affidabilità adeguati, distribuire nodi locali può aumentare inutilmente la complessità. L’edge è utile quando risolve un vincolo concreto, non perché sia automaticamente più moderno.